AI
Gemini-Omni 可能是如何实现的
本文是我对 Google 最新视频编辑/生成模型 Gemini-Omni 可能实现方式的一些高层推测。
仅凭公开信息还无法确定具体架构,但我认为有三种合理的可能性,按概率从高到低排列:
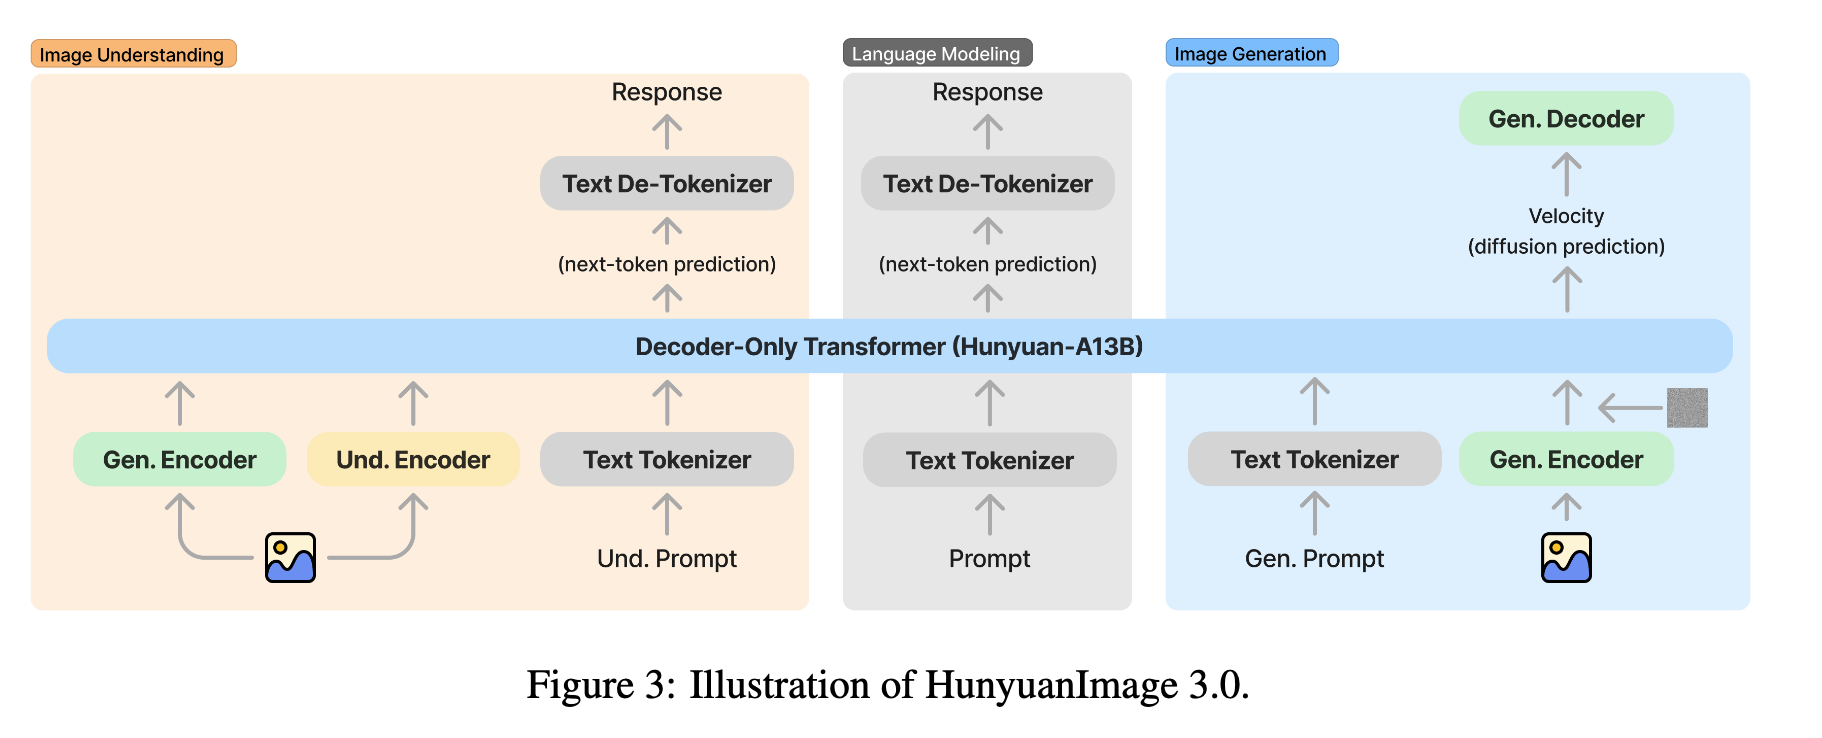
- Transfusion / HunyuanImage-3.0 式的单一统一 transformer,联合完成多模态理解与生成。最有可能是 Gemini-Omni 的方案。
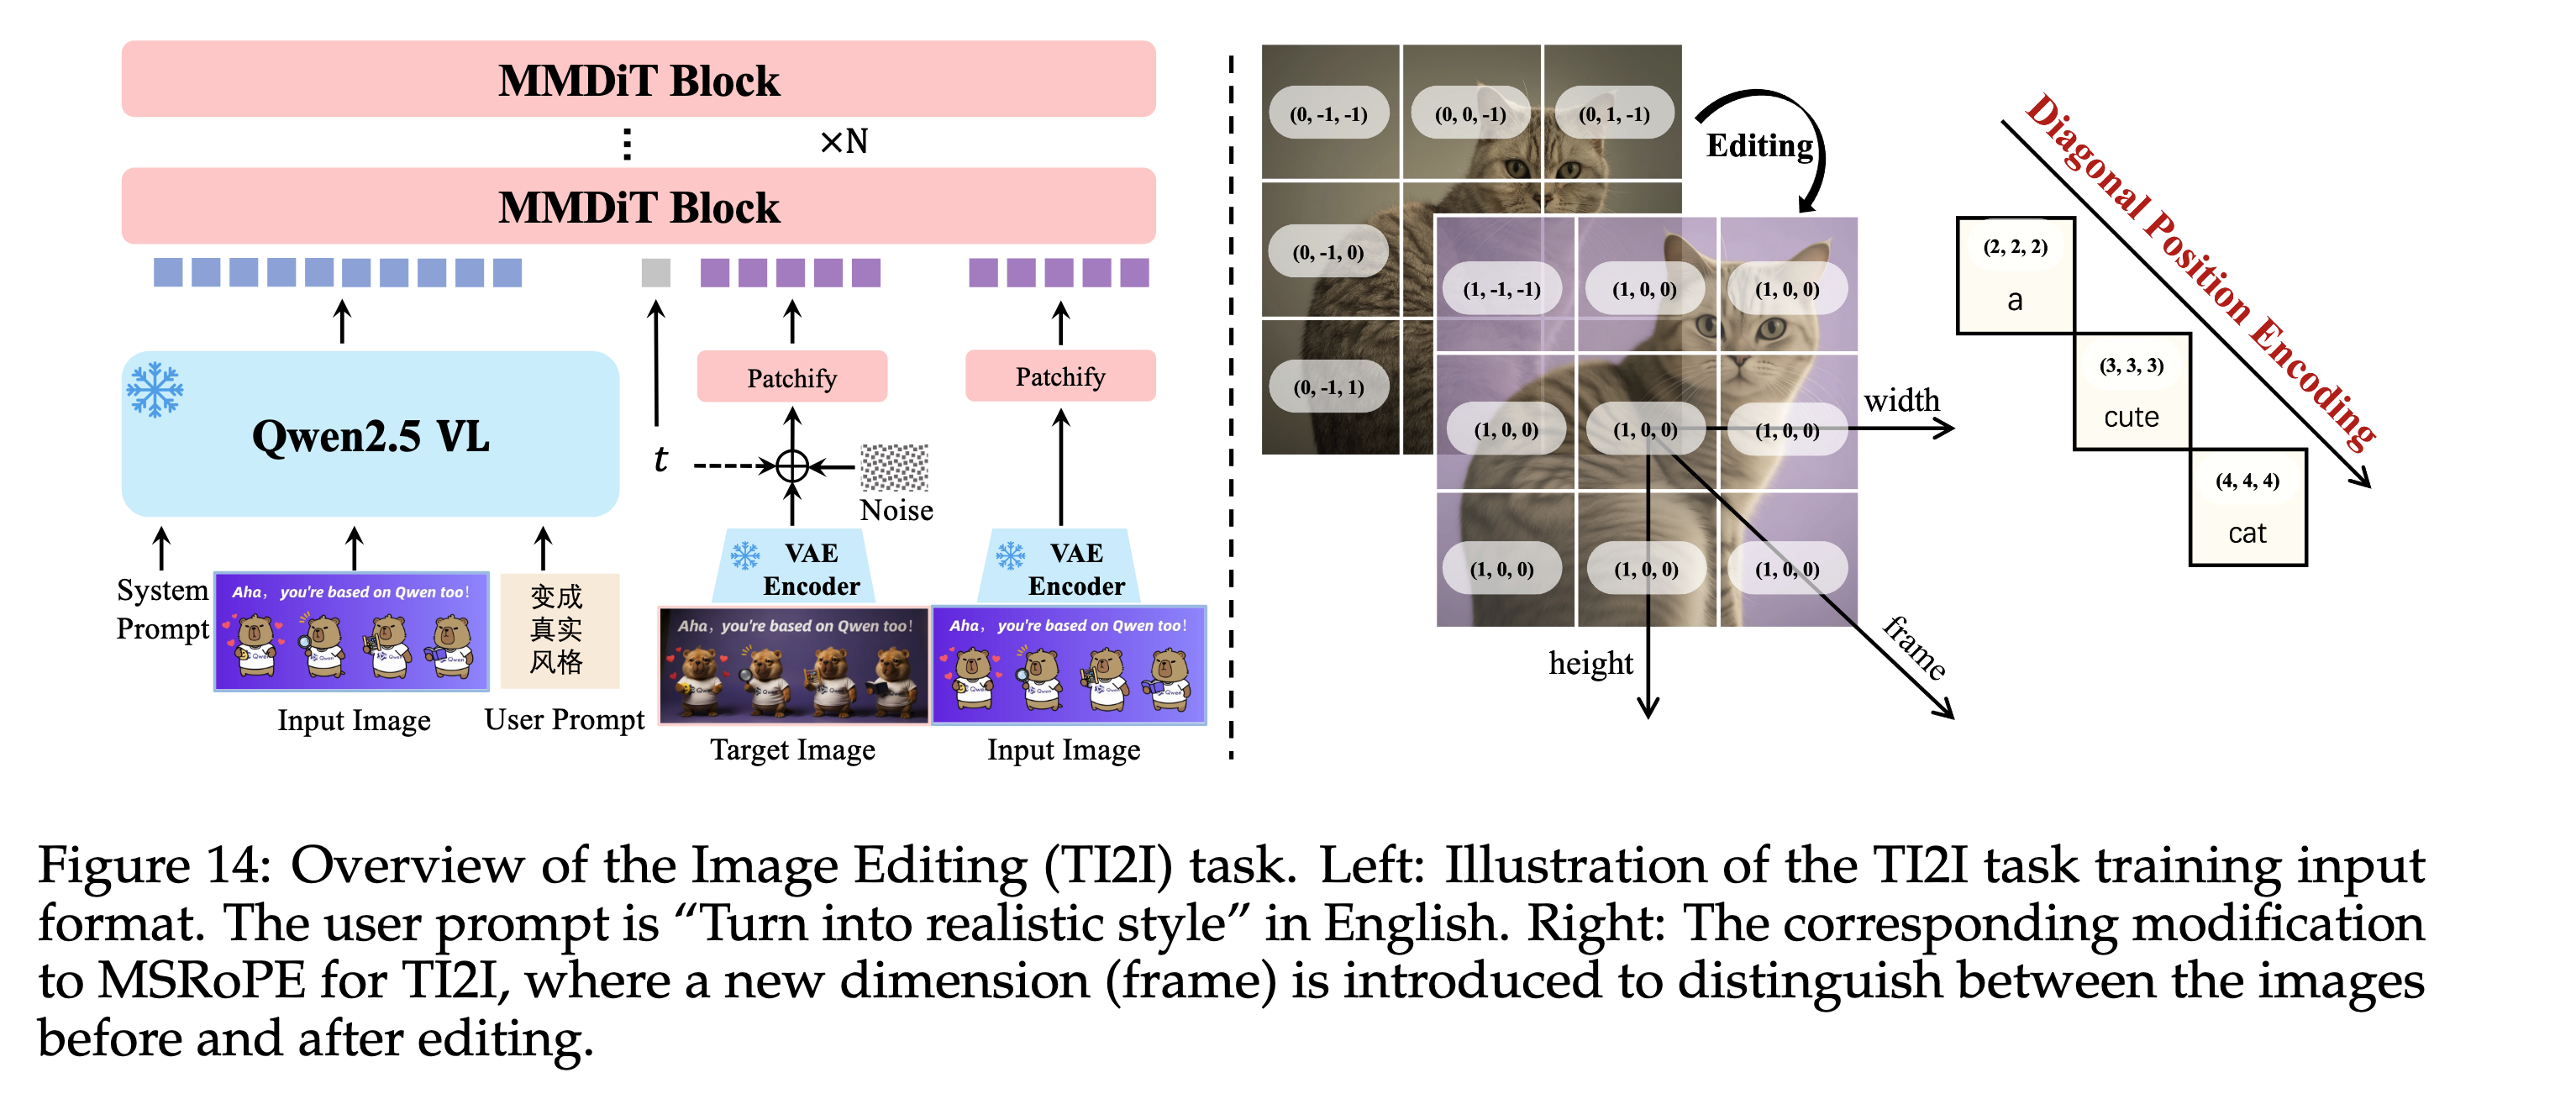
- Qwen-Image-Edit 式的编码器-解码器系统:Gemini 作为多模态编码器,其输出的 embedding 作为条件输入给 flow matching 模型来渲染视频。最有可能是 Veo 3 的方案。
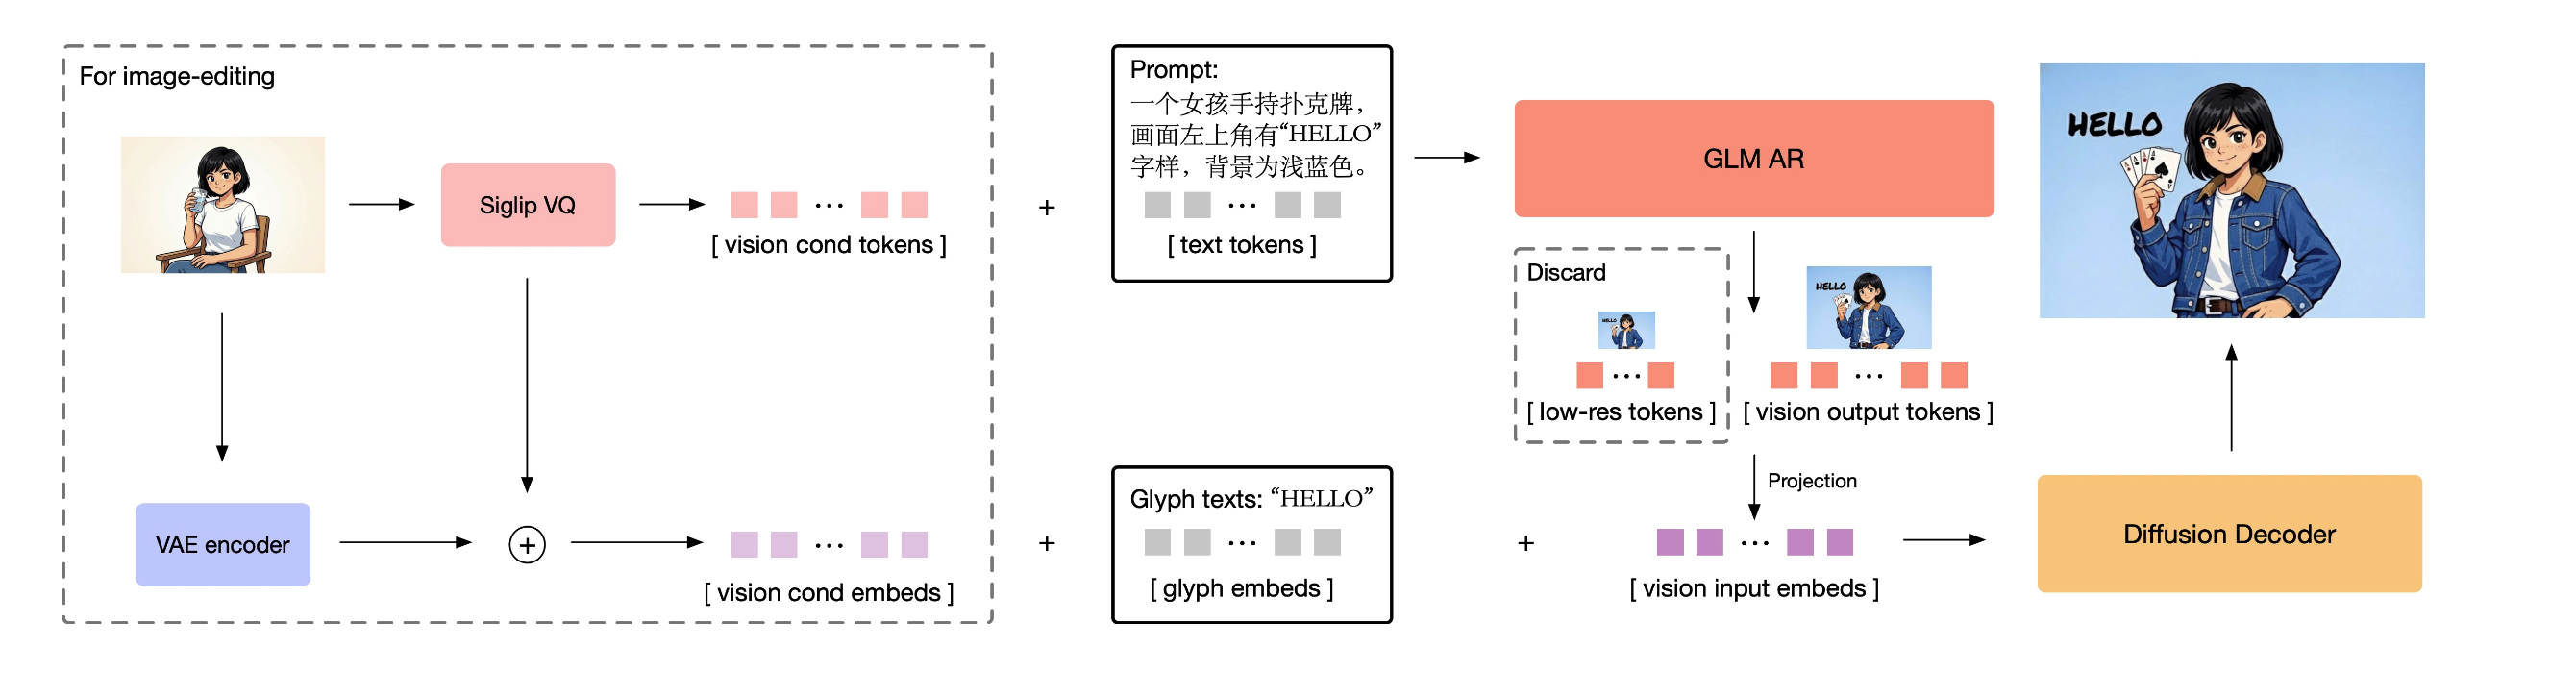
- GLM-Image 式的混合架构:在离散空间自回归地生成粗粒度视觉 token,再在连续空间用扩散模型精修。对图像来说是可行的,但不太可能成为今年稠密视频生成的主路线。
我认为 Transfusion 式的统一模型是 Gemini-Omni 最有可能采用的架构。
路线一:Transfusion
这是 Transfusion 式的技术路线,也是我对 Gemini-Omni 的首选猜测。
核心思想是用一个共享的 transformer 同时处理两件事:
- 对文本和离散 token 做 next-token prediction(下一个 token 预测)
- 对连续的图像、视频、音频 latent 做 flow matching
简化的训练/推理流程:
Text / Image / Video / Audio Context
          ↓
Shared Multimodal Transformer
          ↓
Next-token prediction (discrete modality like text generation) + Flow matching (continuous modality like video/image/audio generation)
          ↓
Text, Images, Video, or Audio Output
模型使用分块因果掩码(blockwise causal mask):文本区域(因果注意力)按标准的 next-token prediction 训练,而视觉/音频区域(全注意力)则用 flow matching 目标训练。
为什么这个方案有吸引力:
目前大多数扩散系统仍采用编码器-解码器架构:编码器是一个文本编码器,把文本 prompt 编码成 embedding;解码器是一个 DiT,负责迭代去噪。
早期用的是很小的 CLIP 文本编码器,比如 Stable Diffusion。在当时,这种编码器-解码器架构是合理的,反正编码器本身就很小。
现代 DiT 则改用更重的 LLM(如 Mistral)或 VLM(如 Qwen2.5-VL)作为文本编码器,FLUX 2.0 和 Qwen-Image-Edit 都是如此。从简单的 CLIP 换成更大规模的预训练 LLM 是合理的:它能带来更好的 prompt 对齐,并支持多模态条件输入(例如原生支持参考图像/视频)。
如今编码器可以是一个巨大的多模态模型,比如约 250B 参数、45B 激活参数的 Gemini 3.5 Flash。这样一个庞大的模型已经能深入理解 prompt、源视频、音频、对话和编辑意图,却只被当作 embedding 提取器来用,未免太浪费了。
类 Transfusion 的统一模型消除了“负责理解的模型”和“负责生成的模型”之间这种别扭的割裂。它通过统一的损失函数把架构统一起来(反正文本编码器和 DiT 本来都是 Transformer),不仅带来更好的 prompt 对齐,还实现了多模态理解与生成的联合建模——这一点对编辑任务尤为重要。
Gemini-Omni 名字里的 “Omni” 也强烈暗示这是一个跨模态既能理解又能生成的单一模型家族——而这正是这条路线所提供的。
路线二:Gemini 作为多模态编码器 + DiT 作为视频渲染解码器
这条路线沿用 Qwen-Image-Edit 的模式,并应用到视频上。
Gemini 并不取代视频主干网络。它扮演多模态编码器的角色,其输出的 embedding 作为条件输入给 DiT,由 DiT 渲染出用于生成或编辑的视频。
架构:
Text / Image / Video / Audio / Dialogue Context
          ↓
Gemini Multimodal Model
          ↓
Prompt rewriting + Dense multimodal embeddings
          ↓
Latent Video/Audio Diffusion Model
          ↓
Edited Video + Audio
主要优势:
- 让视频生成器保持专精,确保高视觉质量
- 只需改进 Gemini 就能升级理解能力,迭代更容易
- 可以复用强大的 Gemini 和 Veo 预训练模型
这很可能就是 Veo 3 最有可能采用的架构:Gemini 负责理解意图,DiT 负责渲染。
局限:它仍然是一个双系统 pipeline,而不是真正的单一 “Omni” 模型。
路线三:自回归粗粒度 token + 扩散精修
这是 GLM-Image 式的混合架构。
模型先自回归地生成粗粒度视觉 token:布局、结构、构图和低分辨率内容;然后由扩散模型把它们精修成高质量输出。
流程:
Prompt / Multimodal Context
          ↓
Autoregressive Model → Coarse Discrete Visual Tokens
          ↓
Diffusion Refinement Model
          ↓
High-Quality Image or Video
这套方案在图像上表现非常出色。但对于稠密视频,token 数量会爆炸——视频同时包含空间、时间、运动、时序一致性,往往还有音频。即使做了压缩和分层,代价依然非常高。
我把这条路线看作视频生成的未来版本,因为收益非常明确:可以把 LLM 的全套技术直接用到视频生成上,比如 KV cache、speculative decoding(投机解码)、CUDA Graph 加速,以及现成的训练基础设施。
我目前的猜测
最终排序:
- 统一 Transformer(路线一):最有可能是 Gemini-Omni 的方案
- Gemini-DiT(路线二):最有可能是 Veo 3 的方案
- 自回归 + 扩散混合(路线三):当前视频生成采用的可能性较低,但可能是未来视频模型的路线
Gemini-Omni 这个名字本身就指向统一化,而整个领域也明显在朝着更少的胶水层、更多的跨模态共享建模方向演进(文本、图像、视频、音频,以及未来几个月里用于世界建模的动作模态)。
参考文献
- Google, “Introducing Gemini Omni.”
- Google DeepMind, “Veo 3 Technical Report.”
- Zhou et al., “Transfusion” (arXiv:2408.11039).
- Zhipu AI, “GLM-Image.”
- Qwen Team, “Qwen-Image” and “Qwen-Image-Edit.”
- Tencent Hunyuan, “HunyuanImage-3.0.”
你觉得哪条路线最有可能?欢迎在评论区聊聊你的看法。
喜欢这篇文章?发到自己邮箱,稍后阅读。